Análise de Dúvidas Sociais sem Alucinação: Isolamento Semântico para Blogs B2B em 2026
Monitorar canais sociais em busca de dúvidas reais é o caminho mais rápido para identificar as fricções e perguntas frequentes do seu cliente corporativo. O grande gargalo surge quando equipes de marketing tentam transformar esses questionamentos em artigos de blog utilizando geradores de texto convencionais sem ancoragem factual. Nesses casos, o sistema deduz respostas, projeta números fictícios e alucina sobre especificações de produtos, destruindo instantaneamente a autoridade técnica construída pela sua marca perante compradores exigentes.
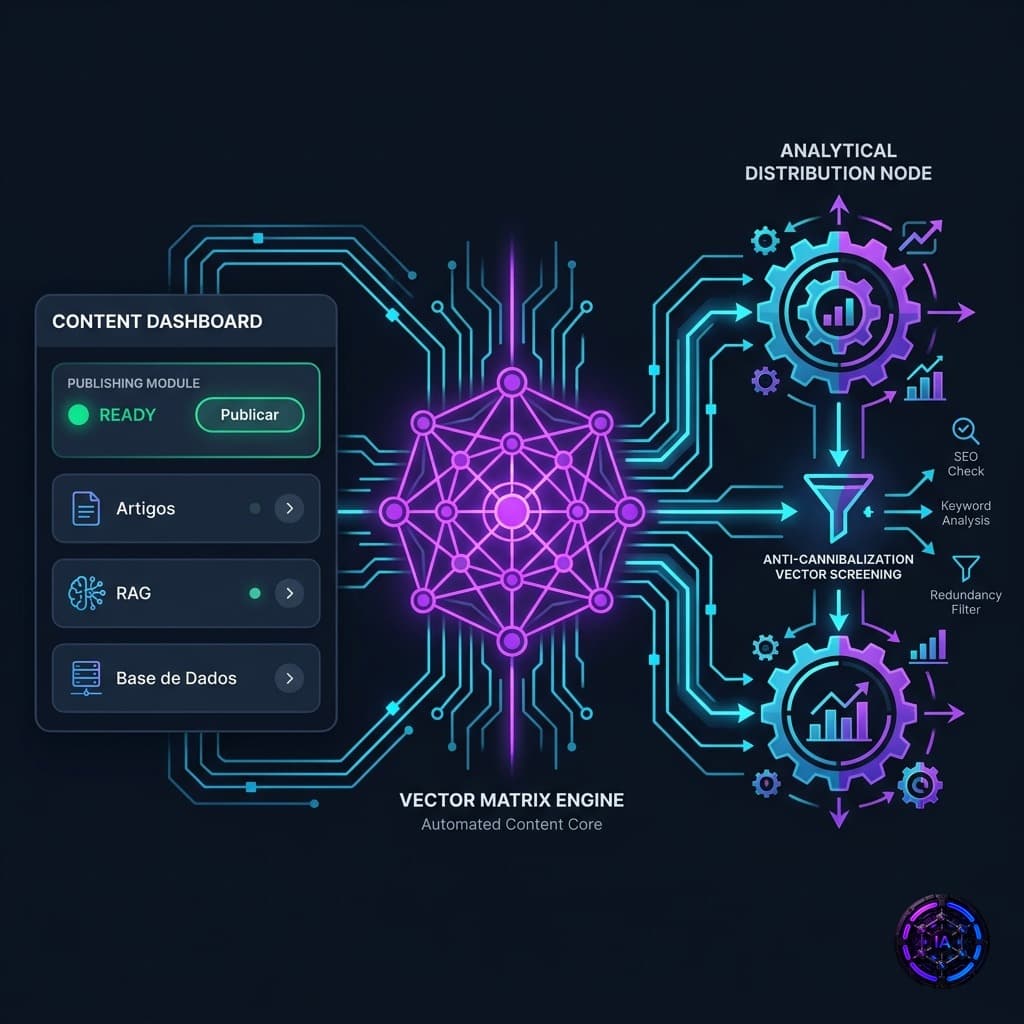
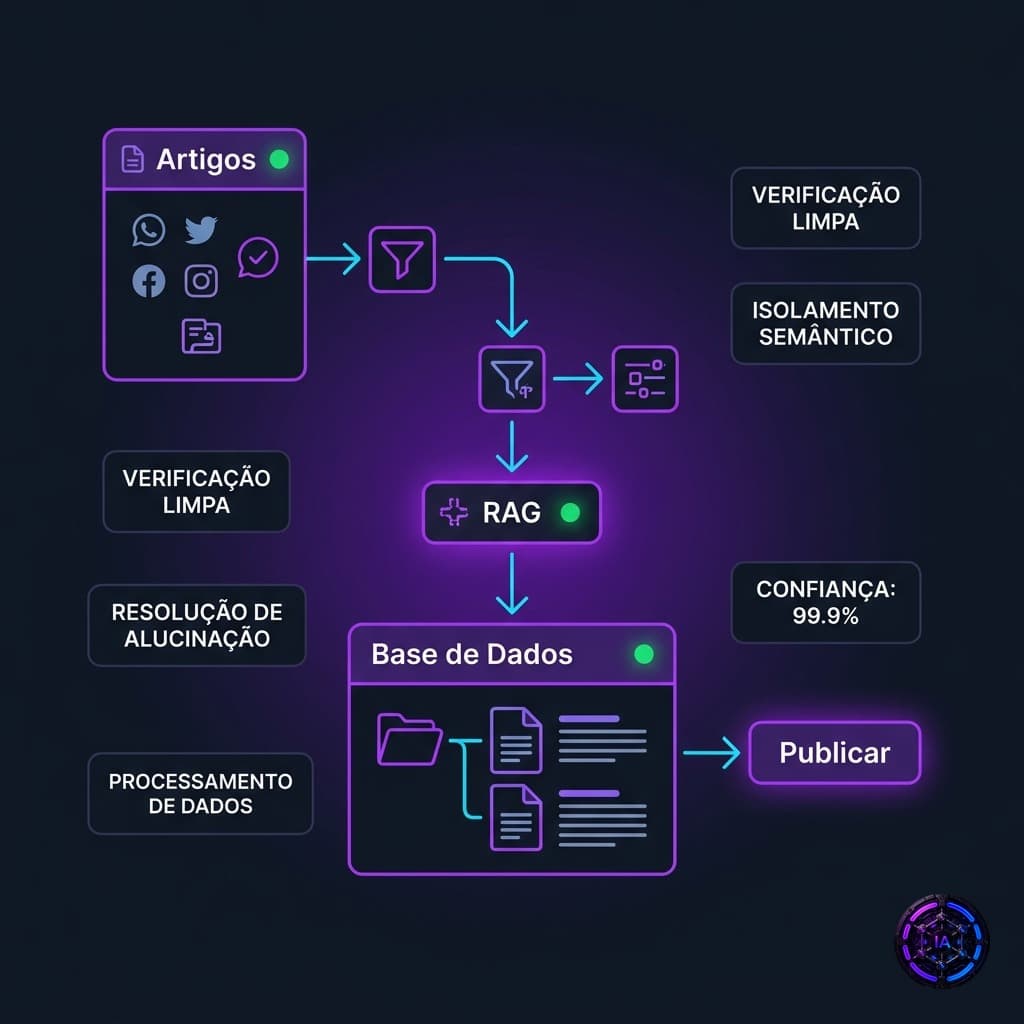
Para o mercado B2B, publicar dados inconsistentes não representa apenas um erro sutil de copy, mas sim perda concreta de negócios e exposição operacional gravíssima. A Inteligência Artificial da Operação IA elimina esse risco estrutural por meio do isolamento semântico de dados. Em vez de permitir suposições soltas, a esteira editorial conecta as dores captadas na escuta social diretamente à Base de Conhecimento RAG Ativa da sua própria empresa, assegurando que nenhuma resposta seja publicada sem lastro em manuais, apresentações, planilhas ou documentos internos validados.
Em 2026, a maturidade de infraestrutura de dados exige que o tráfego orgânico seja nutrido por assertividade técnica. Ao alimentar seu pipeline editorial com documentos oficiais da organização, o marketing corporativo converte conversas e dúvidas do mercado em artigos profundos e autorais para blog, blindando a reputação corporativa e acelerando o ciclo de vendas.
Desmistificando os Maiores Mitos do Mercado
❌ MITO: Modelos convencionais de escrita são suficientes para responder dúvidas técnicas de clientes no blog corporativo.
✅ REALIDADE: Sistemas de escrita genéricos não possuem contexto institucional e operam por adivinhação estatística quando confrontados com regras de negócio específicas. Segundo a metodologia institucional da Operação IA, quando a tecnologia não conhece o catálogo e a documentação interna da sua empresa, ela fatalmente alucina dados, métricas e prazos, gerando posts superficiais que afastam tomadores de decisão qualificados.
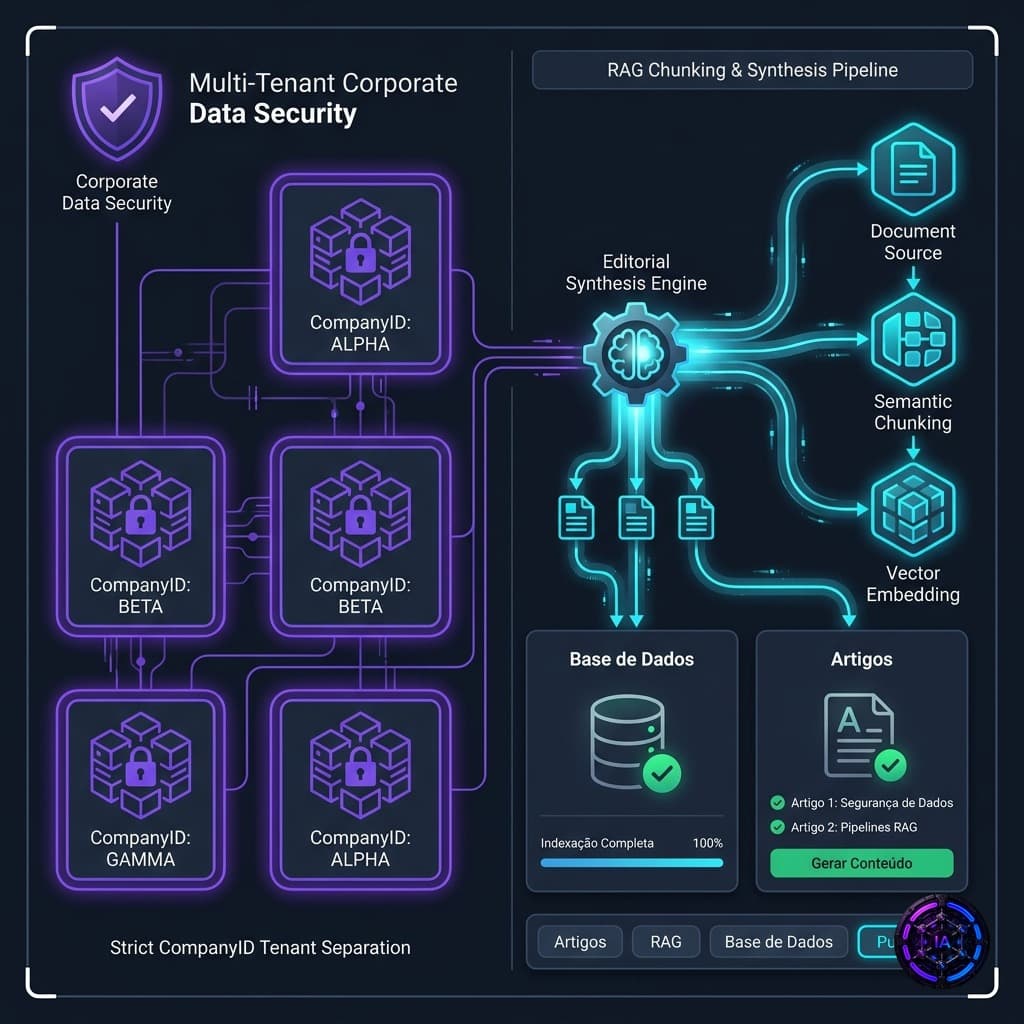
A resposta segura a questionamentos do público requer indexação vetorial estrita via Motor RAG. Documentos oficiais em PDF, Word (.docx) ou planilhas Excel (.xlsx) passam por segmentação semântica (chunking inteligente), permitindo que a Inteligência Artificial da Operação IA consulte exclusivamente fragmentos validados antes de elaborar cada seção do artigo de blog. Essa restrição semântica garante fidelidade factual inegociável em cada parágrafo publicado.
❌ MITO: Integrar documentos confidenciais para alimentar o blog compromete o sigilo de dados e viola a LGPD.
✅ REALIDADE: O receio de vazamento corporativo decorre do uso indevido de ferramentas públicas que utilizam entradas de usuários para treinar redes abertas. No ecossistema corporativo da Operação IA, a arquitetura multi-tenant isola de forma estrita as bases vetoriais e os documentos de cada organização por identificador único (companyId). Nenhum dado corporativo é compartilhado ou utilizado no treinamento cruzado entre clientes, atendendo plenamente aos rigorosos padrões da LGPD.
Além do isolamento lógico, a transferência de materiais a partir de fontes como o conector nativo com Google Drive ocorre sob autenticação OAuth segura. Todo o pipeline de entrega editorial para plataformas como WordPress e Shopify emprega Webhooks protegidos por criptografia AES-256-CBC, garantindo total integridade operacional desde a ingestão do documento até a publicação final do post no blog institucional.
❌ MITO: Produzir conteúdo técnico anti-alucinação a partir de escuta social exige semanas de redação manual e inchaço de equipe.
✅ REALIDADE: A crença de que profundidade técnica exige processos manuais lentos é sustentada por operações defasadas. A centralização de inteligência da Base de Conhecimento RAG Ativa permite que consultores de SEO, gestores de tráfego e agências B2B transformem dezenas de dúvidas mapeadas em artigos estruturados em poucos minutos, sem a necessidade de inflar quadros editoriais ou sobrecarregar especialistas de produto.
A plataforma oferece status de sincronização vetorial em tempo real (SYNCED vs PENDING_SYNC), garantindo que novos materiais importados fiquem prontos para síntese imediata. Com a automação orientada por dados proprietários, a empresa constrói um ecossistema editorial de alto impacto para SEO, reduzindo o CAC orgânico com artigos ricos que quebram objeções comerciais complexas de forma escalável.
Por Que Esses Mitos Custam Caro Para as Empresas
A insistência em esteiras manuais ou em ferramentas sem fundamentação RAG cobra uma conta pesada das operações B2B. O primeiro custo visível é a perda direta de autoridade orgânica e posições de destaque nos mecanismos de busca. Quando um artigo de blog traz informações imprecisas sobre compatibilidade de software, parâmetros fiscais ou normas técnicas, o leitor qualificado abandona a página, gerando sinais negativos de engajamento e deteriorando o ranqueamento editorial da marca.
O segundo impacto crítico reside no inchaço desnecessário da folha de pagamento e no atrito interno constante. Empresas sem uma Base de Conhecimento RAG Ativa dependem de reuniões exaustivas entre redatores e engenheiros de produto para validar rascunhos triviais. Esse retrabalho contínuo gera gargalos severos de entrega, infla o custo por artigo publicado e atrasa o lançamento de conteúdos estratégicos que deveriam estar respondendo às buscas mais quentes do setor.
Por fim, há o custo invisível da canibalização de tráfego orgânico e do descompasso de vendas. Ao produzir conteúdos sem checagem de similaridade vetorial prévia, a empresa coloca seus próprios artigos para disputar as mesmas palavras-chave no Google. Ao adotar a tecnologia da Operação IA, dotada de algoritmos de detecção preventiva de canibalização com score de similaridade por cosseno de até 0.94, a gestão editorial ganha total previsibilidade sobre cada pauta, assegurando relevância sustentável e conversões de alto valor.
O Que Fazer na Prática: As Melhores Diretrizes
-
Estruture a ingestão de dados em bases temáticas isoladas. Em vez de misturar arquivos aleatórios em um repositório desordenado, organize seus documentos na Base de Conhecimento RAG Ativa por pilares específicos, como Catálogo Técnico, Dúvidas Comerciais, Políticas de Suporte e Estudos de Caso. Essa segmentação melhora a recuperação semântica e permite que a Inteligência Artificial da Operação IA elabore artigos para blog com precisão cirúrgica sobre cada assunto abordado.
-
Aproveite a escuta social estritamente como insumo de pauta e perguntas para o blog. As dores e questionamentos observados em canais sociais servem como termômetro de mercado e dados brutos de entrada, jamais como canais de distribuição final de textos longos. Alimente o Estúdio Editorial da plataforma com essas perguntas frequentes e vincule a geração aos manuais oficiais para que a síntese entregue respostas densas e prontas para indexação orgânica nos buscadores.
-
Padronize a validação vetorial contínua antes de autorizar publicações em massa. Monitore o status de sincronização dos arquivos (SYNCED) e realize testes de consistência semântica nos rascunhos gerados. Com a publicação nativa de 1-clique via Webhooks seguros em WordPress ou Shopify, sua equipe assegura cadência analítica ininterrupta, convertendo conhecimento corporativo interno em autoridade digital inquestionável.
Elimine alucinações e transforme os documentos da sua empresa em uma esteira escalável de artigos para blog. Acesse https://operacaoia.com.br e inicie seus testes gratuitamente na plataforma da Operação IA.